
NVIDIA
NVIDIA CUDAGeForce
RTX.
Imágenes. Vídeo. Asistentes.
Linux x64 y Windows con WSL2.Modelos recomendados según la VRAM de tu GPU.
Requisitos de RAM y VRAM por modelo.
 bajalatencIAAcceder al estudio
Acceso público · Próximamente
Genera imágenes y vídeos con IA, en Cloud o en tu equipo.
Tú eliges el modelo y dónde se ejecuta cada creación.
macOS · Linux · Windows con WSL2 · Desde 16 GB RAM
Sin tarjeta. Solo información sobre el acceso.
TU ESTUDIO DE GENERACIÓN
Crea imágenes a partir de texto o referencias, genera vídeo y consulta la actividad de tu equipo. Modelos de IA y resultados visuales, desde una sola interfaz.


TU EQUIPO. DESDE TU MÓVIL.
Conecta tu Mac con Apple Silicon o tu equipo con NVIDIA RTX. Gestiona los modelos, lanza generaciones y consulta los resultados desde el móvil, estés donde estés.
Tu equipo debe permanecer encendido, conectado a Internet y con el agente activo. No necesitas mantener el navegador del móvil abierto.
Consulta las arquitecturas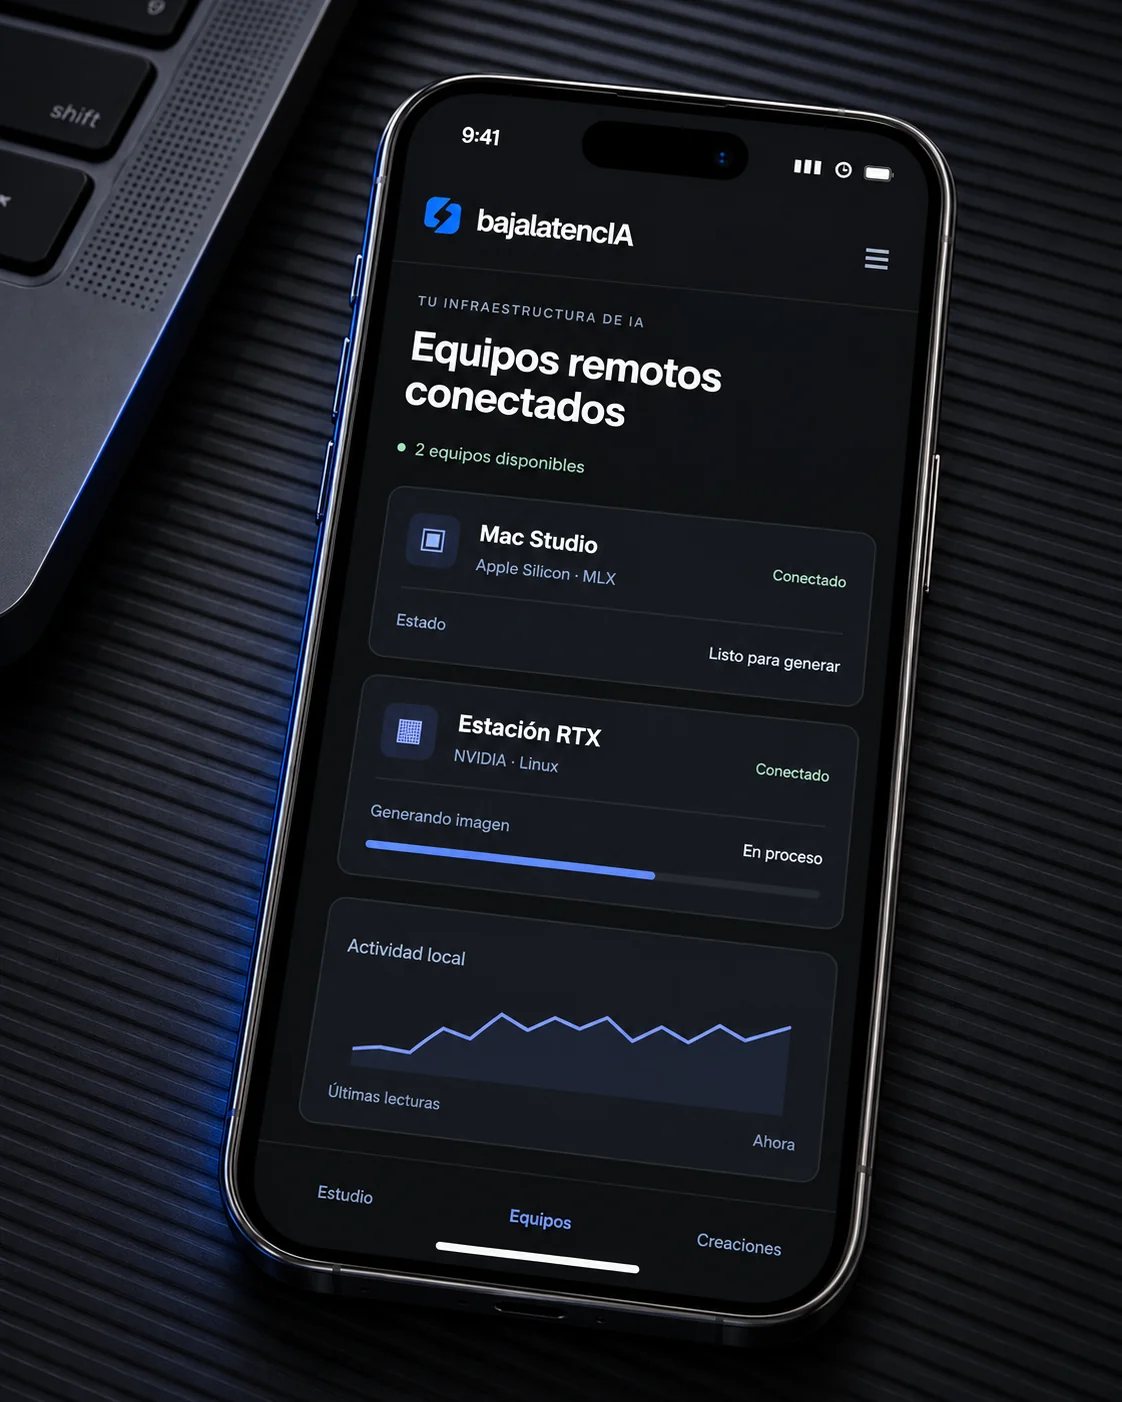
ARQUITECTURAS LOCALES
El estudio comprueba tu hardware y muestra los modelos compatibles. La RAM, la VRAM y el sistema operativo determinan qué puedes ejecutar.
NVIDIA
NVIDIA CUDAImágenes. Vídeo. Asistentes.
Linux x64 y Windows con WSL2.Modelos recomendados según la VRAM de tu GPU.
Requisitos de RAM y VRAM por modelo.
APPLE SILICON
MLX
Modelos de imagen y vídeo en tu Mac con Apple Silicon. Asistentes de texto y visión con Ollama.
macOS 14+ · Desde 16 GB de RAM.NVIDIA DGX SPARK
En evaluación
CPU ARM y GPU Blackwell en un mismo superchip. Una arquitectura distinta a la de los equipos RTX x64.
Linux ARM64: instalador para asistentes Ollama.Representaciones conceptuales del hardware. El soporte específico de DGX Spark está en evaluación. Especificaciones de DGX Spark
ANTES DE EMPEZAR
Equipos, control remoto y próximos pasos.
Resuelve tus dudas antes de empezar.
Un estudio web para crear imágenes y vídeos con modelos locales y Cloud. Conecta tus equipos, utiliza asistentes locales para preparar tus prompts y conserva tus creaciones en un mismo lugar. El acceso se aprueba individualmente desde la lista de espera.
Los instaladores detectan macOS (Apple Silicon o Intel), Linux x64/ARM64 y Windows mediante WSL2. Se requieren al menos 16 GB de RAM. MLX utiliza Apple Silicon; las variantes NVIDIA CUDA para Linux/WSL2 comprueban también la VRAM y el driver. Mac Intel y Linux ARM64 ofrecen asistentes Ollama. Cada modelo indica sus requisitos antes de instalarlo.
Sí. Puedes seleccionar explícitamente un equipo vinculado a tu cuenta y utilizarlo en remoto desde el navegador del móvil. La inferencia sigue ejecutándose en ese equipo: debe permanecer encendido, con Internet y con el agente activo. Cerrar el navegador no detiene un trabajo ya enviado.
No. Tú eliges el modo de ejecución y el modelo antes de generar. En Local utilizas un equipo compatible de tu cuenta; en Cloud consultas el presupuesto y confirmas el consumo de créditos.
Su compatibilidad específica está en evaluación. DGX Spark utiliza GB10 Grace Blackwell con CPU ARM. El instalador Linux ARM64 contempla asistentes Ollama, pero las recetas de imagen y vídeo CUDA del estudio solo están disponibles en x64. No presentamos DGX Spark como generación visual ya validada.
En Local, el modelo se ejecuta en tu equipo. Las referencias, los resultados y el historial se guardan en el backend Cloud del estudio para que puedas acceder desde otros dispositivos. Si eliges un modelo Cloud, la solicitud se envía además al proveedor de ese modelo.
El acceso al estudio se aprueba individualmente. Apúntate a la lista de espera y te avisaremos un día antes del lanzamiento.
Todavía no hay una fecha anunciada. Déjanos tu email y te avisaremos un día antes del lanzamiento. No necesitas crear una cuenta para apuntarte.
No. Es un proyecto independiente. Las marcas y arquitecturas mencionadas identifican tecnologías y equipos; no implican afiliación ni certificación de sus fabricantes.